Colibri:讓你的現有硬體跑 744B~2.8T 參數前沿 MoE 模型的純 C 推理引擎
發布時間:
Colibri:Tiny Engine, Immense Model
把 744B~2.8T 參數的前沿 MoE 模型,跑在你已經擁有的硬體上。

📊 專案速覽
| 項目 | 資料 |
|---|---|
| 名稱 | Colibri |
| Stars | ⭐ 30,741 |
| Forks | 3,305 |
| 語言 | C |
| 授權 | Apache-2.0 |
| 版本 | v1.11.0 |
| 建立時間 | 2026-07-01 |
| 網站 | justvugg.github.io/colibri |
🎯 核心概念
Colibri 的核心洞見:MoE 模型不需要「裝進」快速記憶體,只需要「放置」。
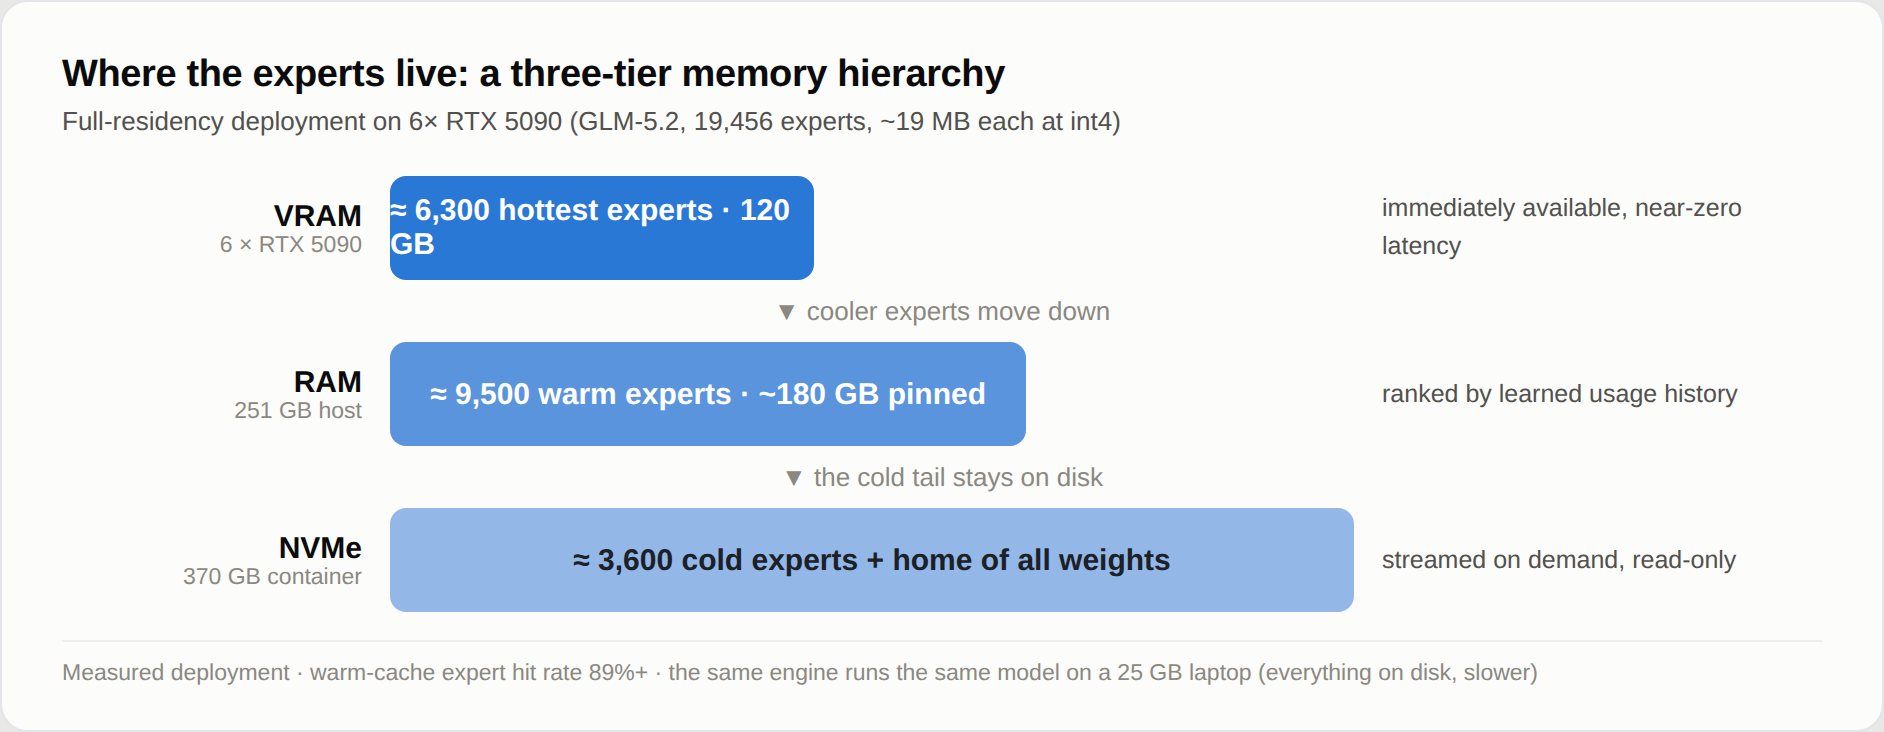
一個 744B MoE 模型每 token 只激活 ~40B 參數,且每 token 間只有 ~11 GB 的路由專家會變化。Colibri 把 VRAM、RAM、NVMe 視為單一多層記憶體階梯,透過「weights JIT」(即時權重調度)決定哪些專家放哪裡。
記憶體分層架構
VRAM(最快)→ 最熱門的路由專家
RAM(中)→ 密集部分(attention、shared experts、embeddings)
NVMe(慢)→ 19,456 個路由專家,按需串流
核心技術
| 技術 | 說明 |
|---|---|
| Weights JIT | 像 JIT 編譯器一樣,不預載全部權重,按路由熱度動態放置 |
| Per-layer LRU + Learned Pinning | 記錄哪些專家最常被路由,自動 pin 熱門專家 |
| Router Lookahead Prefetch | 路由器提前一層路由,隱藏載入延遲(71.6% 可預測) |
| Dual-SSD Striping | 兩顆 SSD 各放一份模型,讀取頻寬加倍 |
| Heterogeneous Execution | CPU + CUDA + Metal + Vulkan 混合執行 |
| Speculative Decoding | MTP head 預測 token(int8 head 必需) |
| Compressed KV State | MLA attention 壓縮 KV 狀態(57× 更小) |
🚀 支援的模型
| 模型家族 | 總參數/激活 | 權重大小 | GPU |
|---|---|---|---|
| GLM-5.2/5.3 | 744B / 40B | 372 GB (int4) | 不需要 |
| GLM-5.3-Flash | 321B / 40B | 195 GB | 不需要 |
| Inkling | 975B / 41B | 469 GB | 不需要 |
| Kimi K3 | 2.8T / 104B | 1.6 TB | 不需要 |
| DeepSeek V4 Flash | 284B / 13B | 167 GB | 可選 |
| DeepSeek V4.1 Flash | 552B / 16B | 203 GB | 可選 |
| Qwen3.8-Flash-Next | 125B / 6B | 185 GB | CPU only |
| Qwen3.6 | 35B / 3B | 20 GB | 可選 |
| OLMoE | 7B / 1B | 7 GB | 不需要 |
GPU 永遠只加速,不是必需。 速度由磁碟決定,因為專家是串流載入的。
📈 效能基準
同一引擎、同一 int4 容器,硬體只改變專家存放位置:
| 硬體 | 速度 | 備註 |
|---|---|---|
| 6× RTX 5090(full residency) | 5.8–6.8 tok/s | TTFT ~13s |
| 128 GB CPU-only | ~1.8 tok/s | 暖機後 |
| 單 RTX 5070 Ti | 1.07 tok/s | GPU-resident pipeline |
| Qwen3.6(2× 8GB GPU) | 7.0× | 1.44 → 10.05 tok/s |
| 25 GB dev box | 0.05–0.1 tok/s | 冷機,專案起點 |
💻 快速開始
1. 下載 Colibri
# Linux/macOS/Windows - 無需編譯器
tar xzf colibri-v1.8.0-linux-x86_64.tar.gz -C colibri
cd colibri
python3 coli info  # 引擎就緒 ✓
或從源碼編譯:
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh  # 檢查 gcc/OpenMP、編譯、自我測試
2. 取得模型
GLM-5.2 int4(gs64 + int8 MTP head):
https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp
或自行轉換:
./coli convert --model /nvme/glm52_i4
3. 執行
COLI_MODEL=/nvme/glm52_i4 ./coli chat     # TUI
COLI_MODEL=/nvme/glm52_i4 ./coli plan     # 查看放置規劃
COLI_MODEL=/nvme/glm52_i4 ./coli doctor   # 就緒檢查
./coli web --model /nvme/glm52_i4         # API + Dashboard
🧠 Dashboard 與視覺化
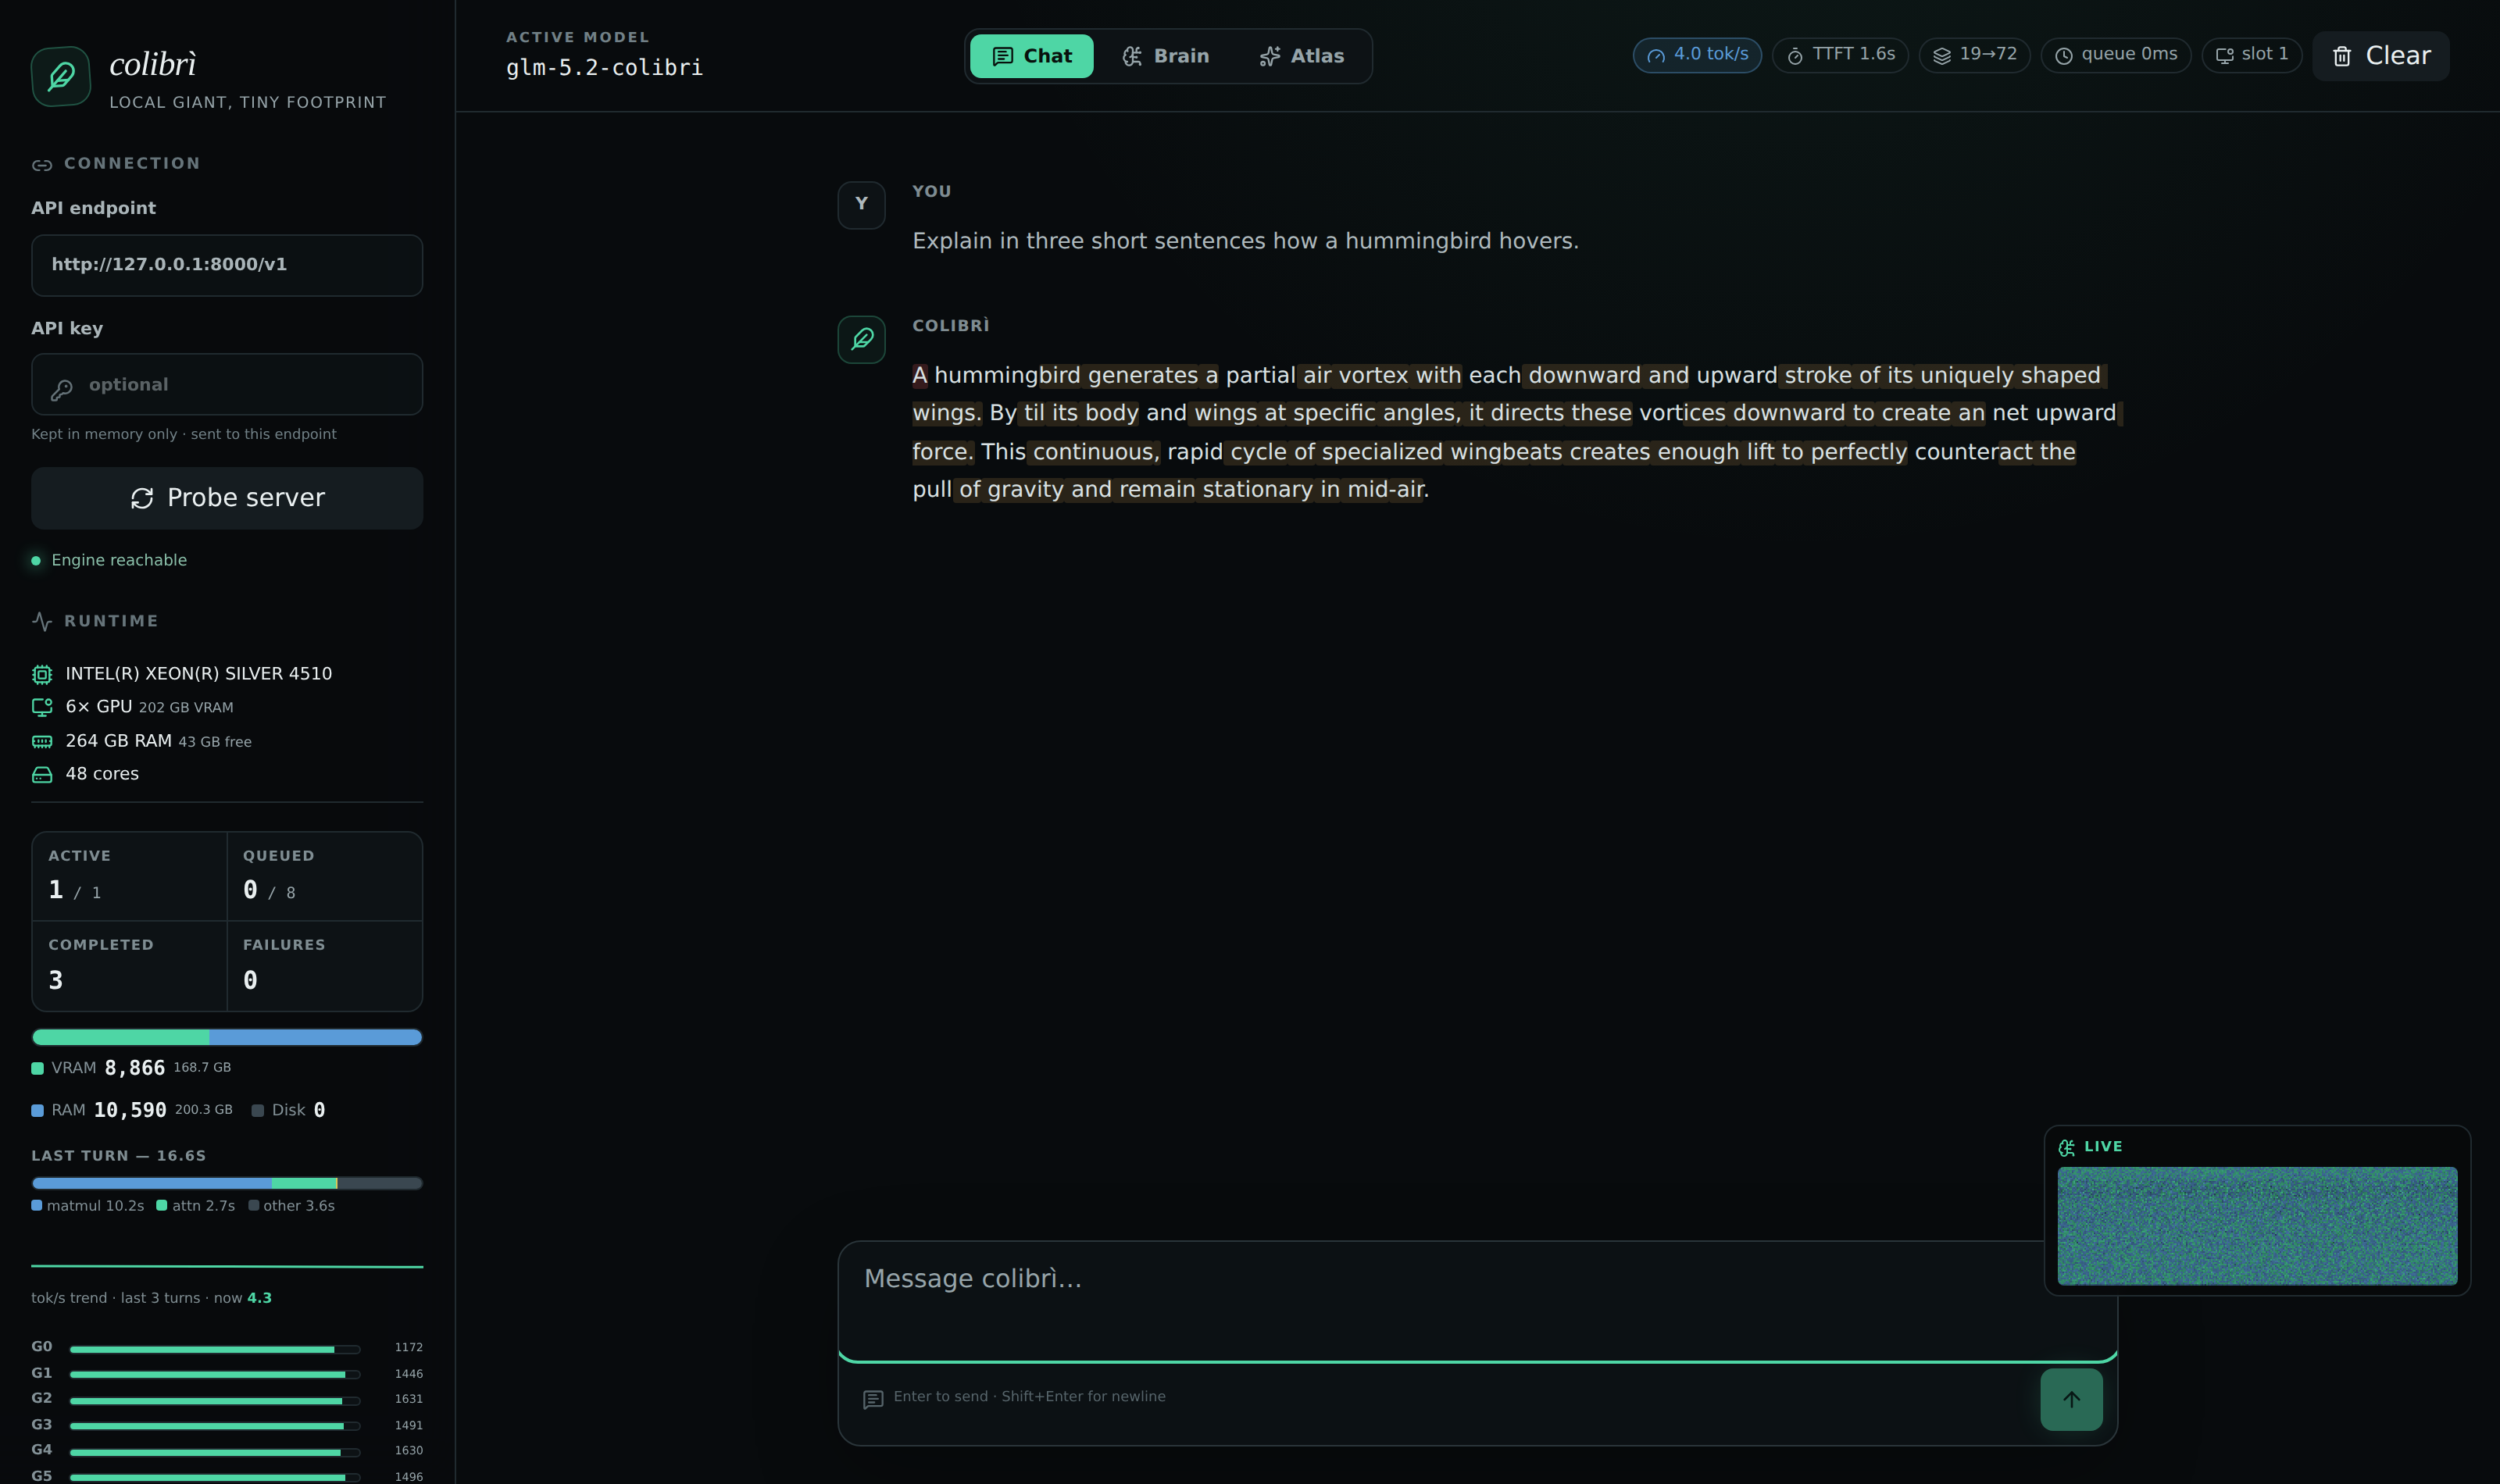
Web Dashboard(./coli web):即時 token 指標、每 turn 時間分解、VRAM/RAM/disk 分層條、右下角 live mini-brain。
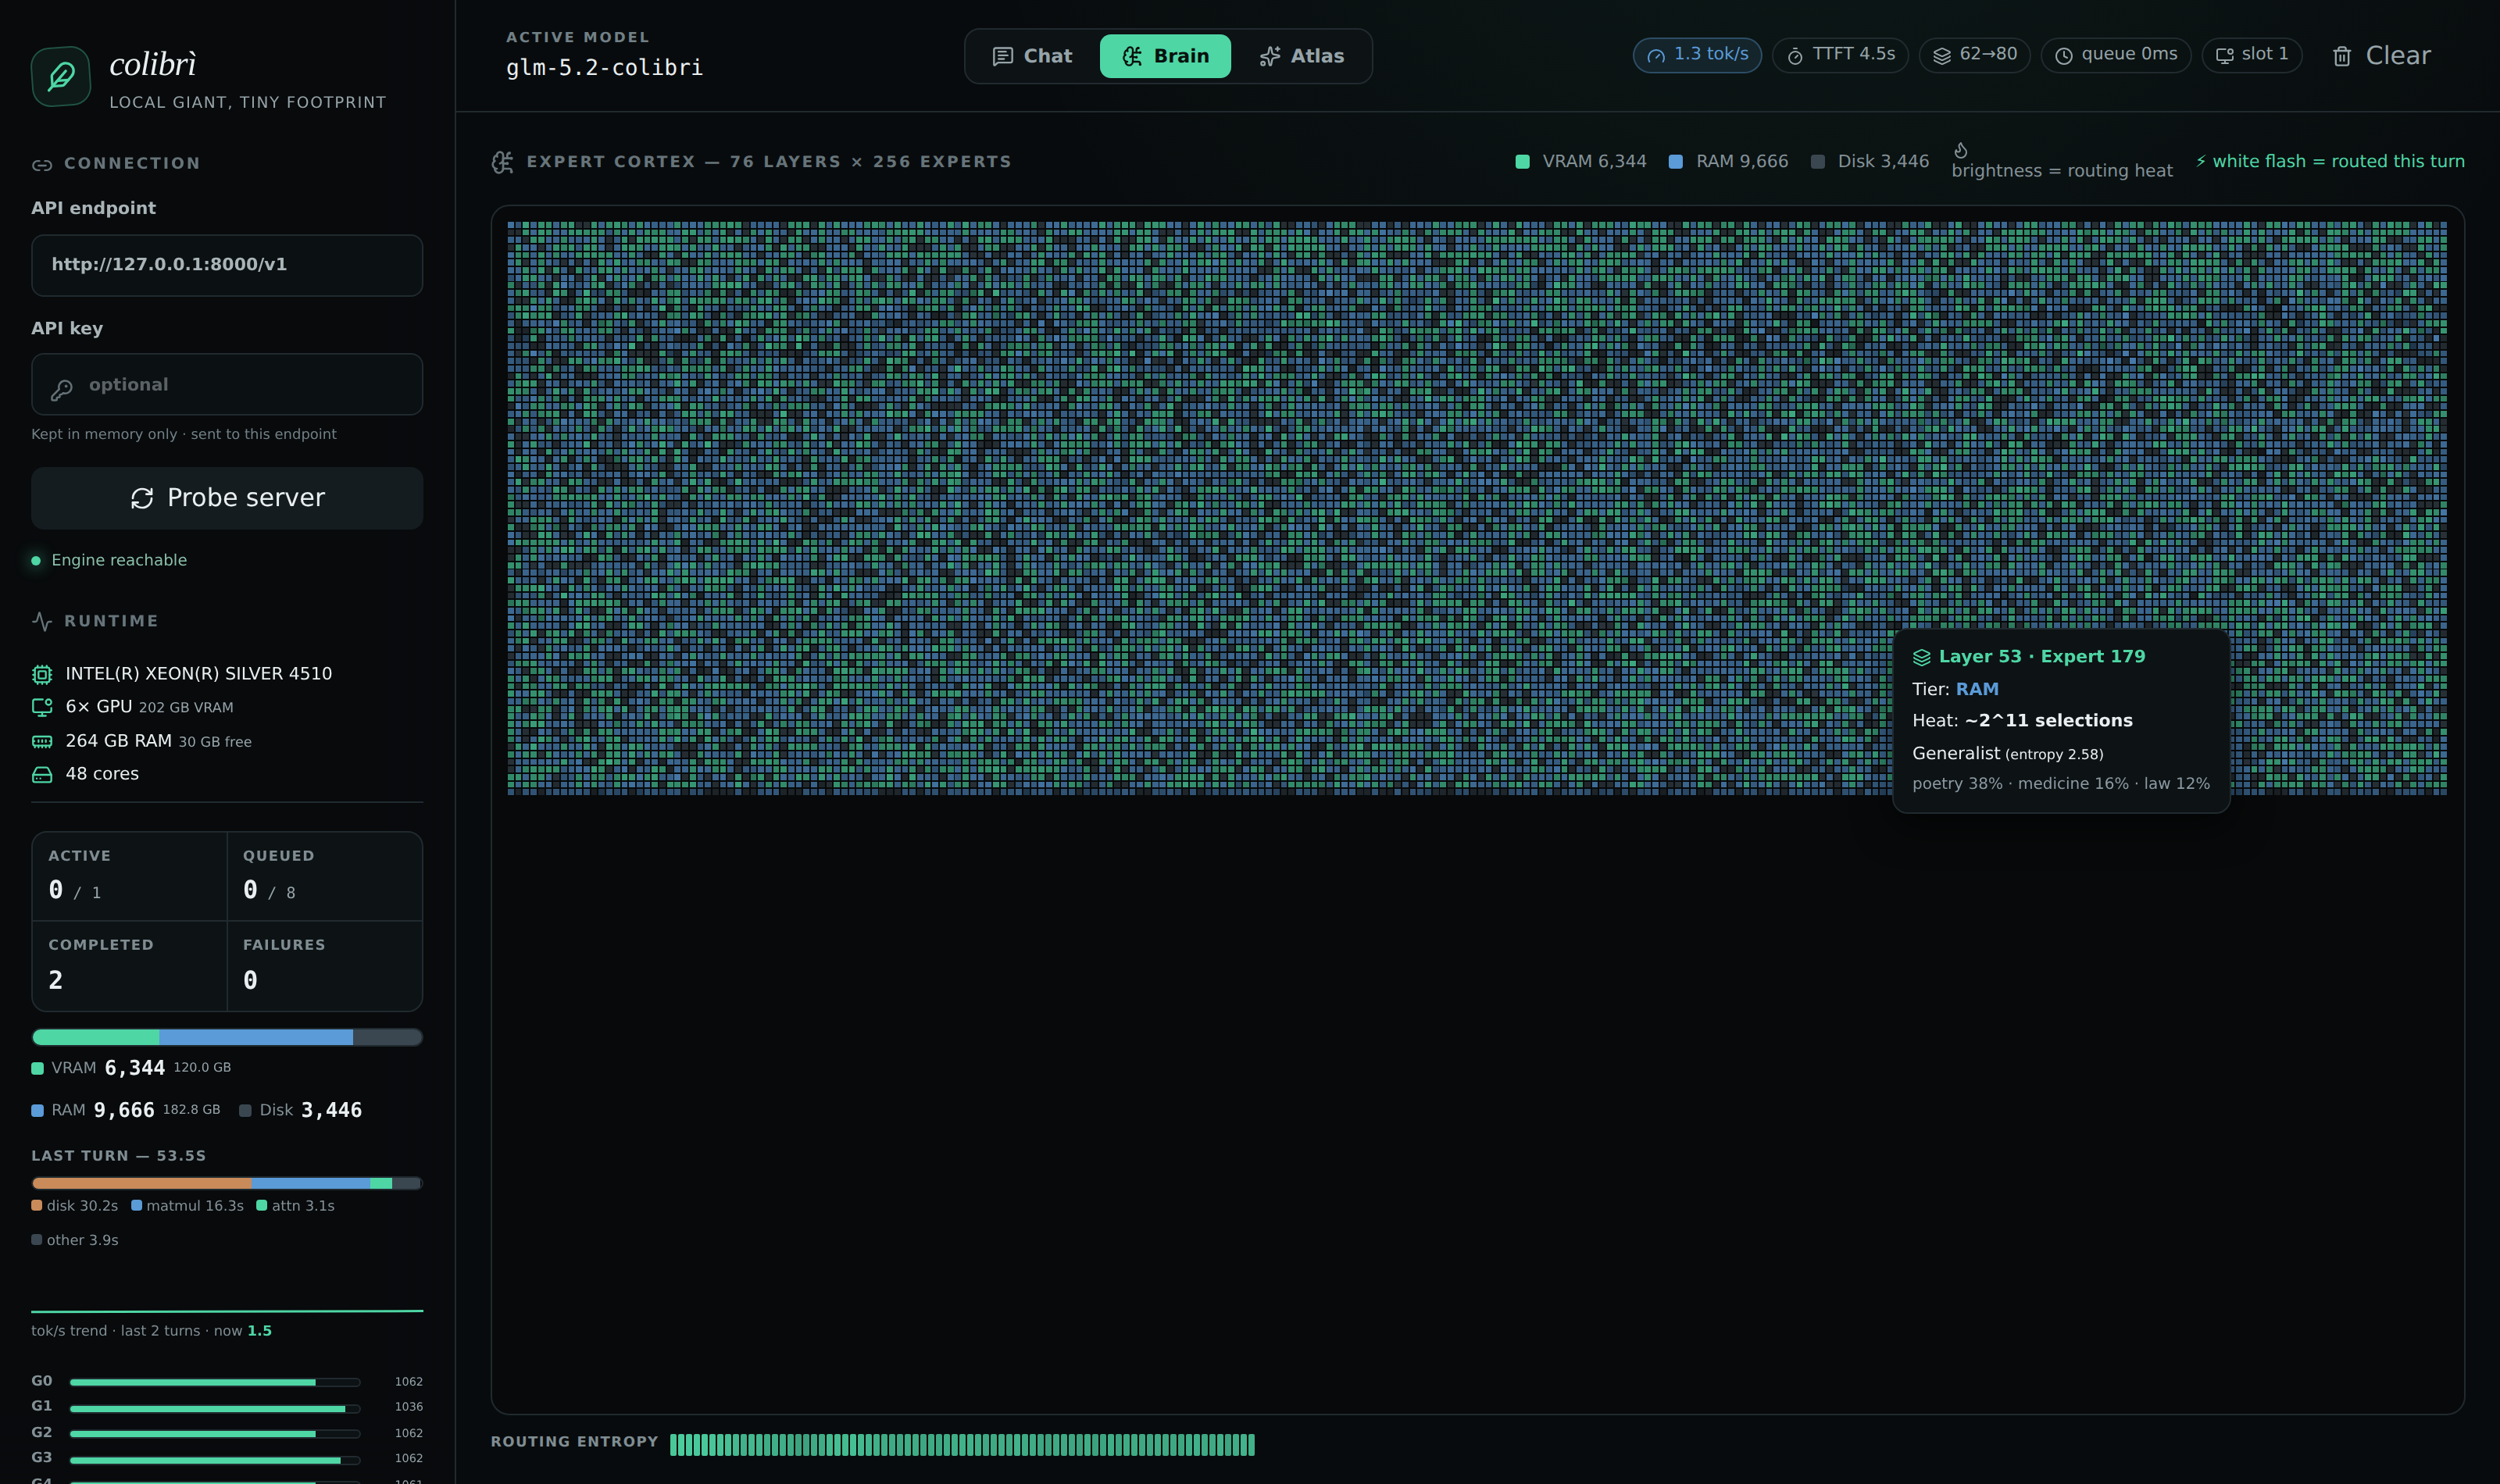
Brain Page:19,456 個專家呈現為活生生的皮質 — 顏色是儲存層級,亮度是路由熱度,每個 turn 被路由的專家閃白。懸停顯示測量的主題親和力。
⚙️ 進階功能
雙 SSD 加速
COLI_MODEL=/fast/glm52_i4 COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat
兩顆 SSD 各放一份模型,讀取頻寬加倍。鏡像驗證在啟動時自動進行,部分鏡像也可工作。
局部鏡像規劃
./c/coli mirror plan --model /fast/glm52_i4 --mirror /second/glm52_i4 --budget-gib 200
./c/coli mirror stage --model /fast/glm52_i4 --mirror /second/glm52_i4 --budget-gib 200
./c/coli mirror verify --model /fast/glm52_i4 --mirror /second/glm52_i4
本地叢集模式
# Coordinator
./coli cluster coordinator --host 0.0.0.0 --port 8765

# Worker
./coli cluster worker --model /nvme/glm52_i4 --port 9100 \
  --coordinator http://COORDINATOR:8765

# Serve with discovery
./coli serve --model /nvme/glm52_i4 --cluster-coordinator http://127.0.0.1:8765
環境變數
| 變數 | 用途 |
|---|---|
COLI_MODEL | 模型路徑 |
COLI_MODEL_MIRROR | 第二份模型路徑(雙 SSD) |
COLI_NUMA=1 | NUMA 記憶體交錯 |
DIRECT=1 | O_DIRECT 繞過 page cache |
PIPE=1 | 非同步 I/O pool(預設) |
PILOT=1 | Router lookahead prefetch(預設) |
DRAFT=0 | 關閉 speculative decoding |
SPEC_PIN=1 | Pin draft+verify 到同一 kernel family |
🏆 為什麼 Colibri 重要?
- 硬體可及性:不需要超級電腦,你的現有硬體就能跑前沿模型
- 純 C 零依賴:引擎是單一 C 檔,無 BLAS、無 Python、無 GPU 必需
- 開放研究平台:每個最佳化都是假設,需要端到端 A/B 測試驗證
- 透明可觀測:Dashboard 顯示每個專家何時被路由,理解 MoE 內部運作
- 多模型支援:同一前端支援 9 個模型家族(GLM、Kimi、DeepSeek、Qwen、OLMoE、Inkling)
- 正確性優先:前向路徑經 transformer oracle 驗證,精度從不默默改變
📚 資源
- 網站:justvugg.github.io/colibri
- Discord:discord.gg/RXV83nSZdk
- Benchmark Protocol:docs/benchmarks.md
- Expert Atlas:Issue #175
- CONTRIBUTING:CONTRIBUTING.md
總結
Colibri 是一個革命性的 MoE 推理引擎,透過「weights JIT」和 AI memory multitiering,讓消費者硬體能執行原本需要超級電腦的模型。它的核心理念是放置而非容納 — 不是讓模型「裝進」記憶體,而是動態決定每個參數應該放在 VRAM、RAM 還是 NVMe。
對於想在本機執行大規模 MoE 模型、研究 MoE 內部運作、或探索推理最佳化的人來說,Colibri 是一個強大的開放平台。
本文於 2026-09-14 整理自 github.com/JustVugg/colibri