Project Maya:在自己的 GPU 上私跑 321B/748B 巨型 MoE 模型
發布時間:
Project Maya:在自己的 GPU 上私跑 321B/748B 巨型 MoE 模型
Project Maya 的定位一句話就能說完:把只有資料中心跑得動的超大 MoE 模型,跑在你現有的電腦上——GLM-5.3-Flash(321B 參數)與 DeepSeek-V4.1-Flash-1017(748B 參數),從一張顯卡到 16 張,NVIDIA 或 AMD,Linux 或 Windows,附引擎、伺服器、瀏覽器面板、OpenAI / Anthropic 雙相容 API 與量化工具。全程數據不出你的機器。
專案概況
| 項目 | 資料 |
|---|---|
| 倉庫 | github.com/mw00/project-maya |
| Star / Fork | ~1,400 / ~175(2026-10-21 查證) |
| 語言 / 授權 | C++ / MIT |
| 建立時間 | 2026-10-06(成立兩週即破千星) |
| 開發節奏 | 極快——v1.1.21 發布於當天(2026-10-21) |
| 作者 | Peasant Smith(@mw00),共同維護者 @needmorevram |
| 模型下載 | huggingface.co/peasantsmith |
| 血統 | 引擎由 Strata fork 後重寫,量化格式與 CPU kernel 取自 ggml / llama.cpp |
核心原理:專家的三層分級
這種規模的模型(748B 參數)光權重就數百 GB,傳統思路是「全部塞進顯存」。Maya 的做法是按使用頻率分層搬運:
你對話中最常觸發的專家 → 常駐 GPU(VRAM)
次常觸發的專家        → 放記憶體(RAM)
其餘的專家            → 留在 NVMe SSD,就地讀取(read-in-place)
        ↓
聊天過程中按實際使用情況即時搬移
引擎會量測你的 GPU、CPU、RAM、SSD 並自動調參
這正是 MoE(混合專家)架構的紅利:321B 參數的 GLM-5.3-Flash 每個 token 只激活約 18B,748B 的 DeepSeek 同樣是稀疏激活——只要把「你常用到的那批專家」放近,其餘的從 SSD 流式讀取,速度就能達到實用區間。代碼中还保留 MTP 區塊(投機解碼前置起草)進一步拉高吞吐。
支援的模型與量化版本
GLM-5.3-Flash(zai-org,321B,MIT 授權,上下文最高 1M token)
Maya 官方以 Z.ai 的 FP8 原版為基準做了一系列量化,實測保留 97.7%–99.2% 的零樣本準確率:
| 版本 | 大小 | 適用 | 對 FP8 原版 |
|---|---|---|---|
| Maya-S(預設) | 96.5 GB | 記憶體池(RAM+VRAM)較小的電腦 | 97.9% 準確率;83% 同 next-token |
| Maya-S24 | 94.7 GB | 24GB 以下顯卡:4-bit 注意力多留 ~1.5GB 給專家,解碼 +14% | 97.7%;83% |
| Maya-M | 116 GB | 較大記憶體池;重點層給更多位元,朝工具呼叫/前端程式碼校準 | 97.9%;86% |
| Maya-M-Derisked | 116 GB | Maya-M + 社群權重編輯,降低無差别拒答(實驗性) | 未量測 |
| Maya-L | 156.3 GB | 最大的記憶體池 | 99.2%;90% |
安裝程式會依你的硬體自動推薦該抓哪個版本。社群量化(turboderp 的 EXL3 3.05/4.05 bpw)也可直接跑。
DeepSeek-V4.1-Flash-1017(DeepSeek,748B,MIT 授權)——獨立引擎 maya-ds4
| 檔案 | 大小 | 硬體 |
|---|---|---|
| Maya-S(官方量化,預設):專家 2–3 bit + Engram 表(Q6_K),與原版 92.6% 同 next-token | 340 GB | NVIDIA Volta(V100)起 + AMD;Linux/Windows |
| unsloth UD-Q8_K_XL GGUF | 508 GB | 同上 |
| LibertAIDAI EXL3 2.9 / 3.5 bpw + Engram 表 | 414 / 461 GB | NVIDIA RTX 30 / A100 起 |
另有 DSpark 起草器(8GB):安裝時自動下載並在你機器上實測是否加速,只有真的變快才啟用。視覺塔(1GB,約 320MB VRAM)可選裝,DeepSeek 路徑支援圖片輸入。
實測效能(來自真實用戶的 –bench 回報)
| 機器 | 模型 | 解碼速度 |
|---|---|---|
| 2× H100 80GB | Maya-L(1M 上下文) | 122–124 tok/s |
| 4× RTX 4090 | Maya-S24 | 118 tok/s |
| RTX PRO 6000 Blackwell 96GB | Maya-M(256K) | 81 tok/s |
| 2× RTX 3090(限瓦 225W) | Maya-S24 | 53 tok/s |
| 單張 RTX 5090 32GB | Maya-M | 30+ tok/s |
| 單張 Tesla V100 32GB | Maya-S24 | 26.8 tok/s |
| 2× Tesla P40 24GB(Pascal 老卡) | Maya-S24 | 28 tok/s |
| AMD Radeon 8065S(Strix Halo,160GB 給 GPU)Windows 11 | Maya-S | 29.6 tok/s |
| NVIDIA DGX Spark(GB10) | Maya-S | 16.5 tok/s |
一個 token ≈ ¾ 個英文單字——單張 3090 就能把 321B 模型跑到 26+ tok/s,這是它爆紅的原因。
並行請求(--parallel,最多 8):同一張卡多個請求共用稠密權重讀取,總吞吐 x1.35–x2.02(視模型在 VRAM 的比例),適合多代理或多人共用一台機器。
硬體需求
| GPU | NVIDIA CC 7.0+(V100、RTX 20 起),1–16 張可分層共享;Pascal 實驗性。AMD(實驗性):RX 7900 XT/XTX、Radeon AI PRO R9700 / RX 9070、Strix/Gorgon Halo(Radeon 8060S/8065S) |
| RAM | 32GB 即可運行;更多 RAM = 更多專家近身 = 更快 |
| 磁碟 | 高速 NVMe SSD:Maya-S 約 100GB、Maya-L 約 160GB、DeepSeek Maya-S 約 350GB、unsloth GGUF 約 520GB。不能是 HDD |
| 系統 | Linux(AVX2 最佳)+ CUDA 12.x;Windows 10/11 實驗性(不支援 WSL2);AMD 走 ROCm 7 |
⚠️ 執行時引擎會鎖走幾乎全部空閒 RAM(只留約 6GB)作為專家層——跑 Maya 時其他程式記憶體所剩不多,這是設計不是 bug。
安裝:一支指令
git clone https://github.com/mw00/project-maya.git && cd project-maya
./setup.sh
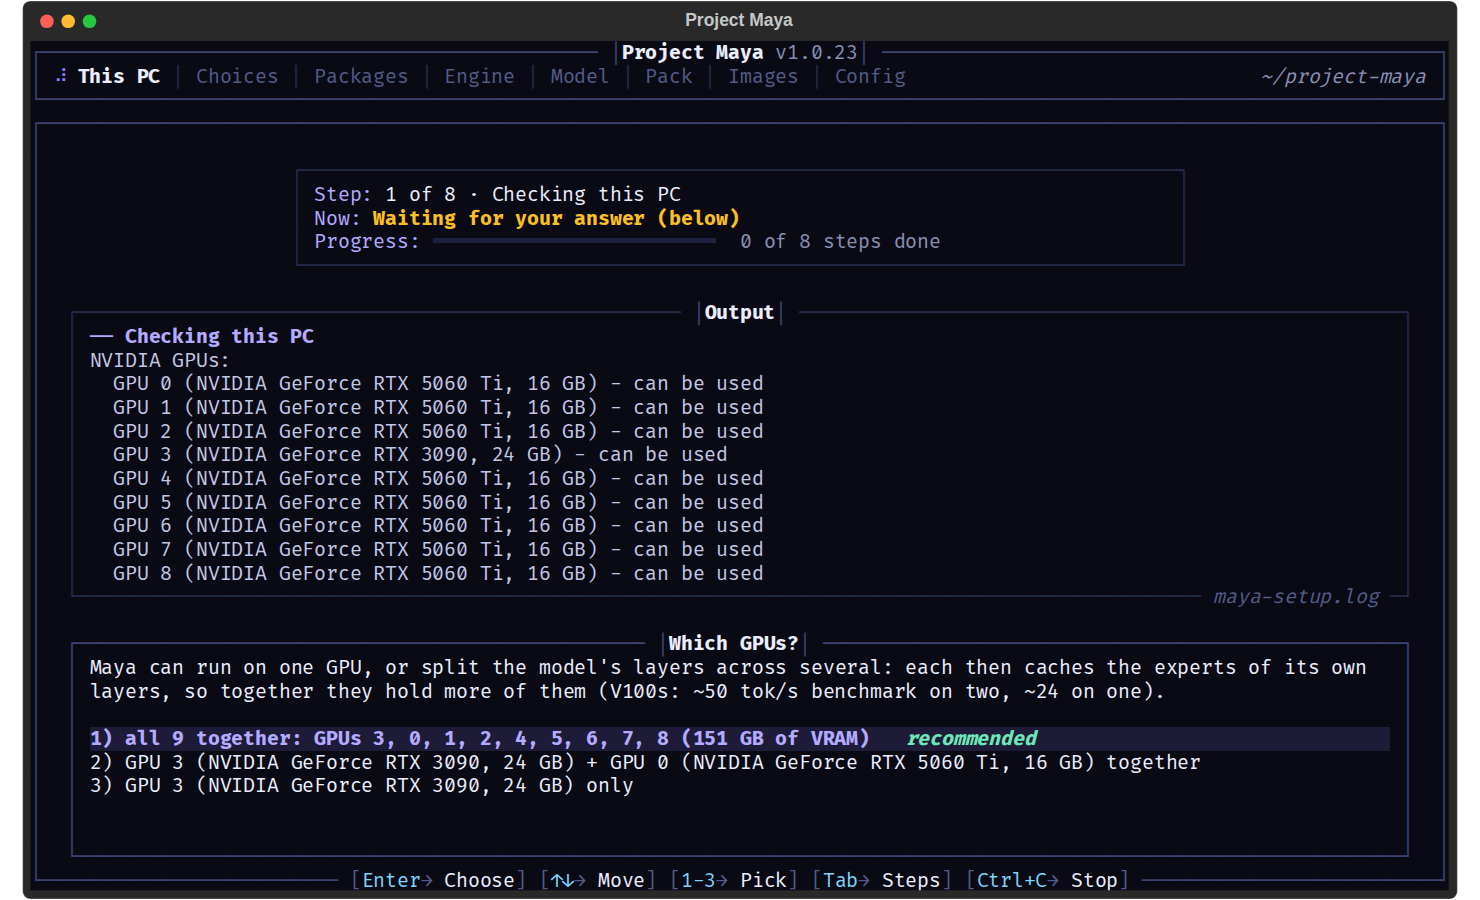
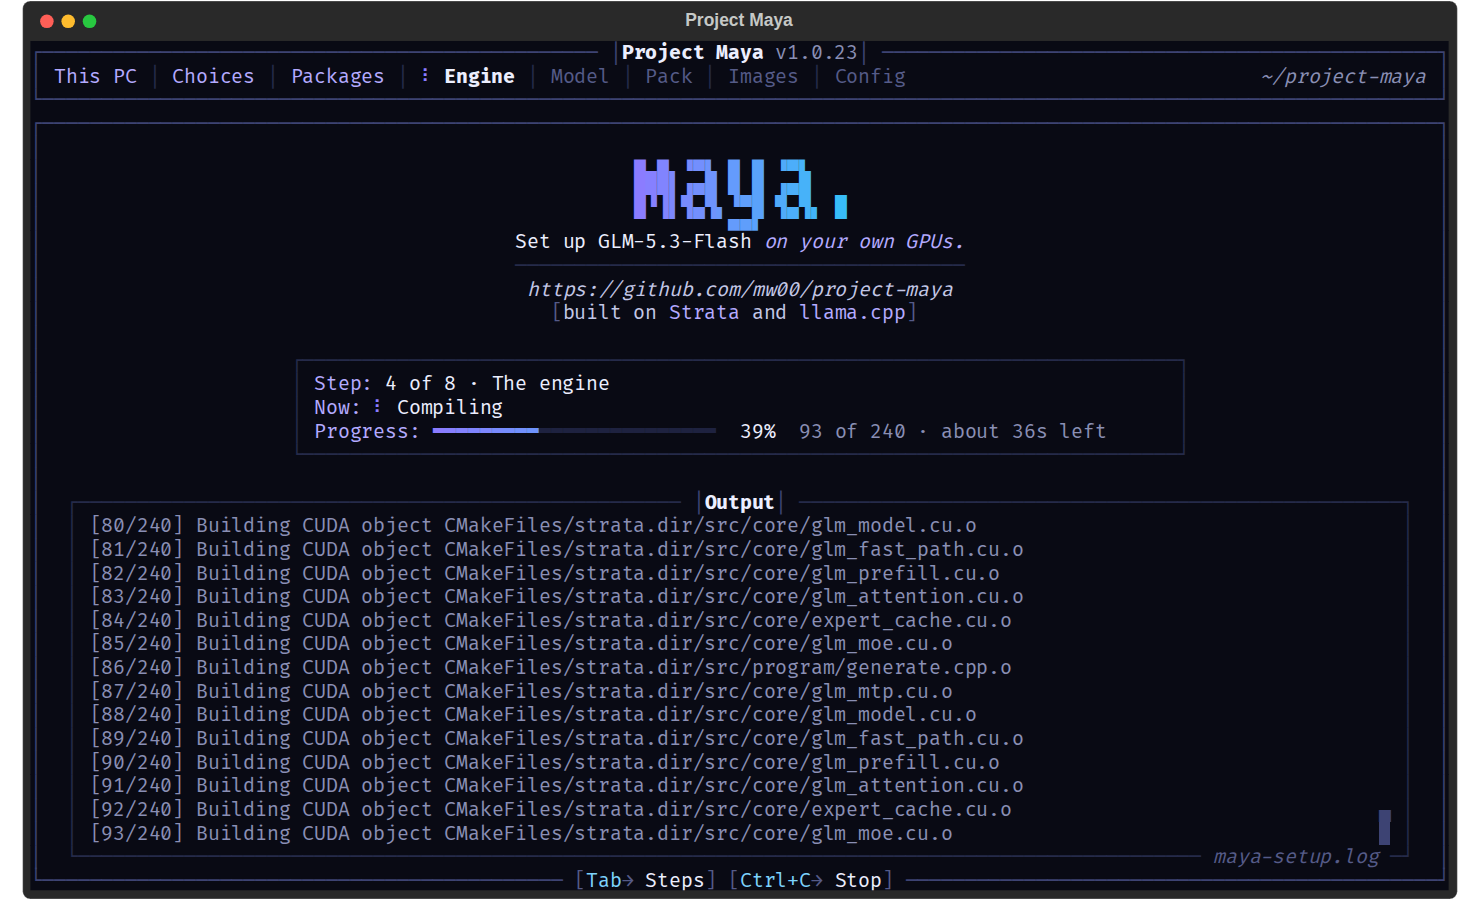
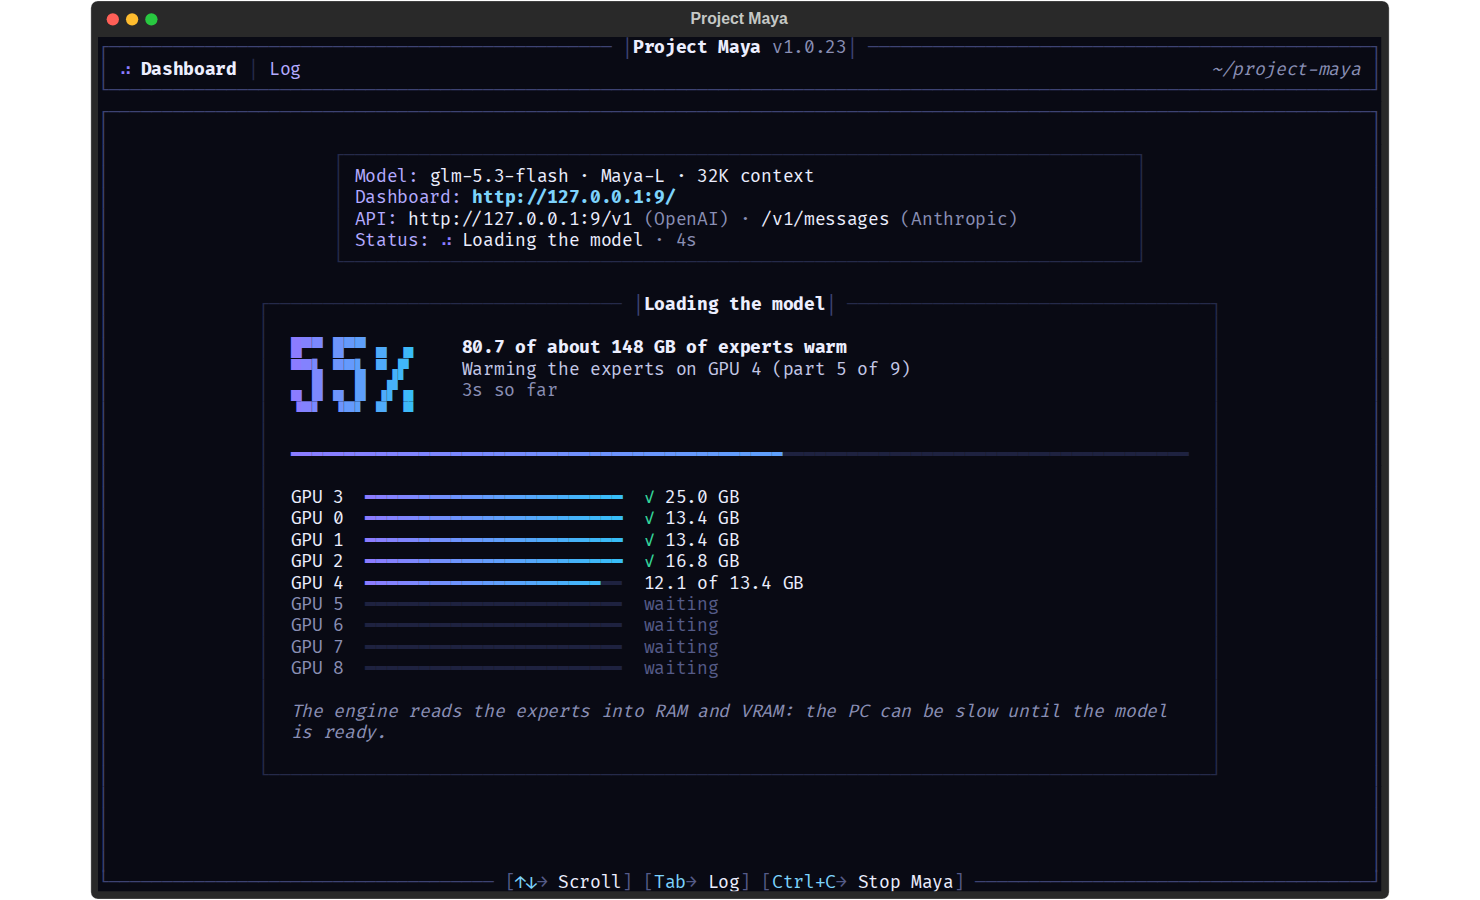
回答幾個問題(預設即建議值),安裝程式先檢查硬體、缺什麼印什麼指令(不裝任何系統級東西)、每個下載都先告知,編譯 20–40 分鐘後直接啟動模型,開 http://127.0.0.1:8080 就能用。Windows 用 START-MAYA.bat。
使用方式
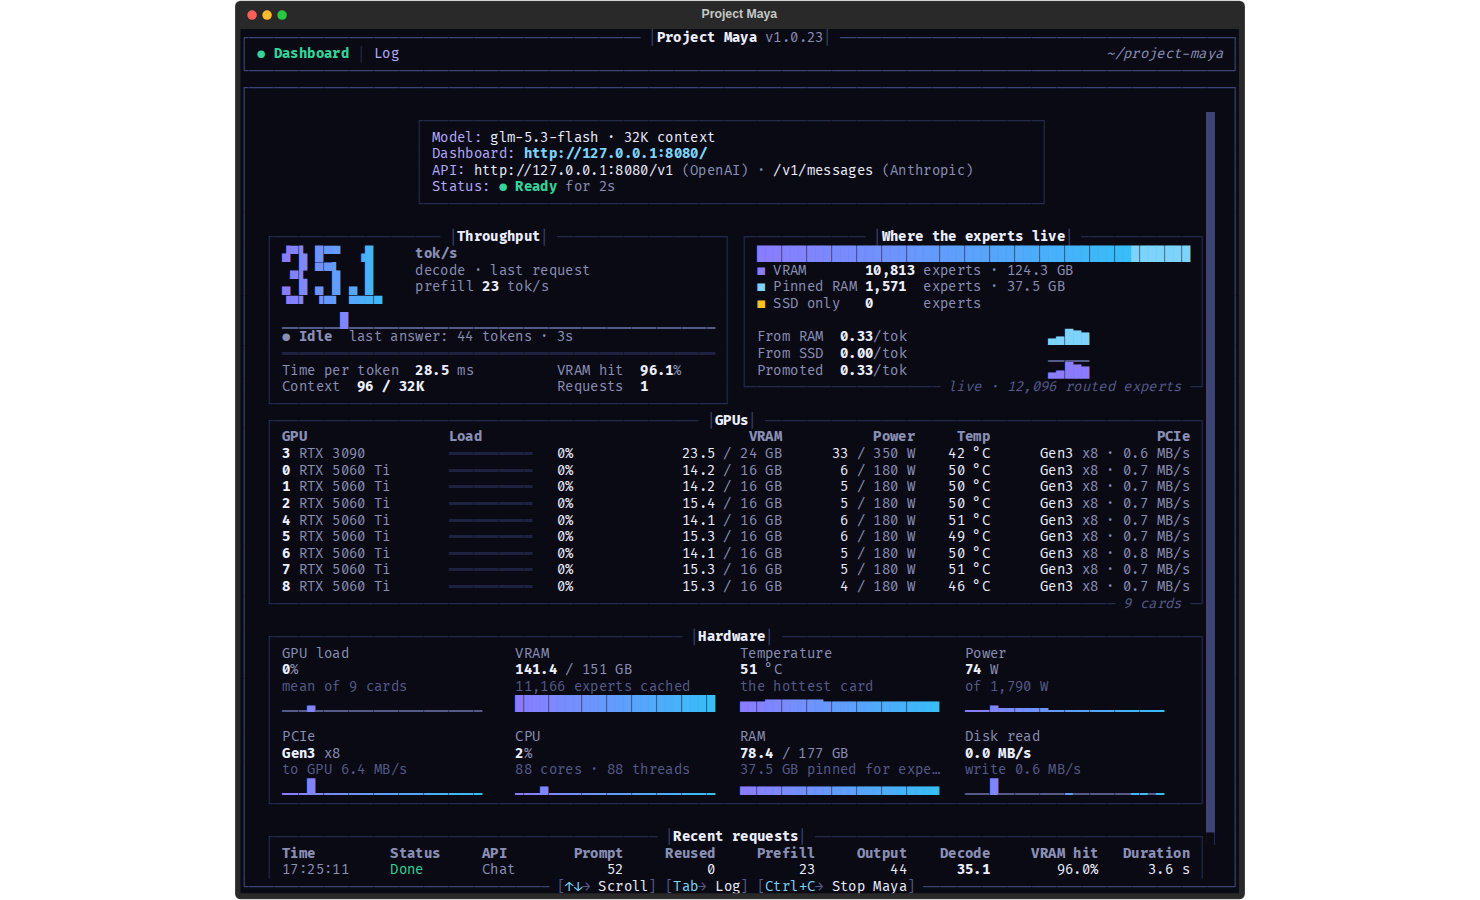
瀏覽器面板
- 聊天:歷史存瀏覽器、逐聊天指令、編輯/重新生成、HTML 預覽、圖片附件
- 即時監視器:模型與硬體狀態精確到每張 GPU 記憶體被什麼填滿——專家的 VRAM/RAM/SSD 分佈一目了然
API(接你的工具與編碼代理)
- OpenAI 相容:
http://127.0.0.1:8080/v1 - Anthropic 相容:
/v1/messages——Claude Code 直接接:ANTHROPIC_BASE_URL=http://127.0.0.1:8080 - Responses API
/v1/responses:文字/圖片、串流、函式工具呼叫、schema 驗證輸出、背景任務取消/重播、選用的共享歷史(previous_response_id) - 工具呼叫隨寫隨串流;長 prompt 的讀取進度可回傳(
return_progress: true) - 跨機使用:
--host 0.0.0.0 --api-key <secret>(文件強調務必設金鑰)
進階調校
- 思考等級:Off / Low / High(預設)/ Max
- KV 串流(
--kv-streaming on):注意力快取放 RAM、VRAM 留視窗——RTX 3090 跑 512K 上下文時 prompt 處理快 4–9 倍,1M 上下文單張 3090 就塞得下 - DFlash2 起草器:每輪投機最多 7 token,Maya-L 九卡 +44%、單張 3090 +19%;同樣由速度校準決定是否啟用(drafter 授權為 CC BY-NC-ND 非商用)
--calibrate:10–15 分鐘針對你的硬體自動調校- 疑難排解:
./maya.sh --report產生 maya-report.txt(硬體+設定+速度行),開 issue 附上即可;下載中斷會續傳
與同類產品比較
| Project Maya | llama.cpp / Ollama | vLLM | 雲端 API | |
|---|---|---|---|---|
| 可跑模型規模 | 748B(家用機) | 受 RAM 上限約束,MoE offload 效率較低 | 需大量 VRAM | 不限 |
| 700B 級私有化成本 | 一台 PC + NVMe | 多機分散式才可行 | 多張 H100/A100 | 按 token 計費 |
| 隱私 | 完全本地 | 完全本地 | 完全本地 | 數據出境 |
| 多模態 | 圖片(兩模型皆支援) | 看模型 | 看模型 | 支援 |
| 上手難度 | 一支指令 + TUI | 中(參數多) | 高 | 最低 |
| AMD / Windows | 實驗性支援 | 支援成熟 | 有限 | — |
Maya 的取捨也很清楚:它專攻「GLM-5.3-Flash + DeepSeek-V4.1-Flash 兩個模型的超大 MoE 本地化」,不是通用推理框架——想跑別家模型請選 llama.cpp/vLLM。
授權與注意事項
- 專案 MIT;底層尊重 Strata、ggml/llama.cpp、exllamav3、beellama.cpp 的 MIT 版權聲明
- 模型本體 GLM-5.3-Flash 與 DeepSeek-V4.1-Flash-1017 均為 MIT
- 例外:DFlash2 起草器 CC BY-NC-ND 4.0(僅非商用,選裝才下載);Maya-M-Derisked 的放寬拒答的編輯屬實驗性
- 執行時鎖 RAM、吃滿 NVMe 讀取——建議專用機器或至少專用時段
- 專案成立僅兩週但迭代極快(當天即 v1.1.21,AMD prompt 提速 2.4×),追新版本成本很低:面板 About > Update 或
git pull && ./setup.sh,模型不用重抓
參考資料
- GitHub:https://github.com/mw00/project-maya
- 模型:peasantsmith/GLM-5.3-Flash-Maya-GGUF · DeepSeek-V4.1-Flash-1017-Maya-GGUF
- 設定全書:docs/SETTINGS.md · 安裝:docs/SETUP.md · Windows:docs/WINDOWS.md · AMD:docs/AMD_MAYA.md
- 量化方法與評測:bench/results/MAYA-S.md 等系列
- Responses API:docs/RESPONSES.md
- 上游:Strata · llama.cpp · exllamav3